
DSpark от DeepSeek: ИИ быстрее на 85% без топовых чипов

Когда санкции становятся двигателем прогресса
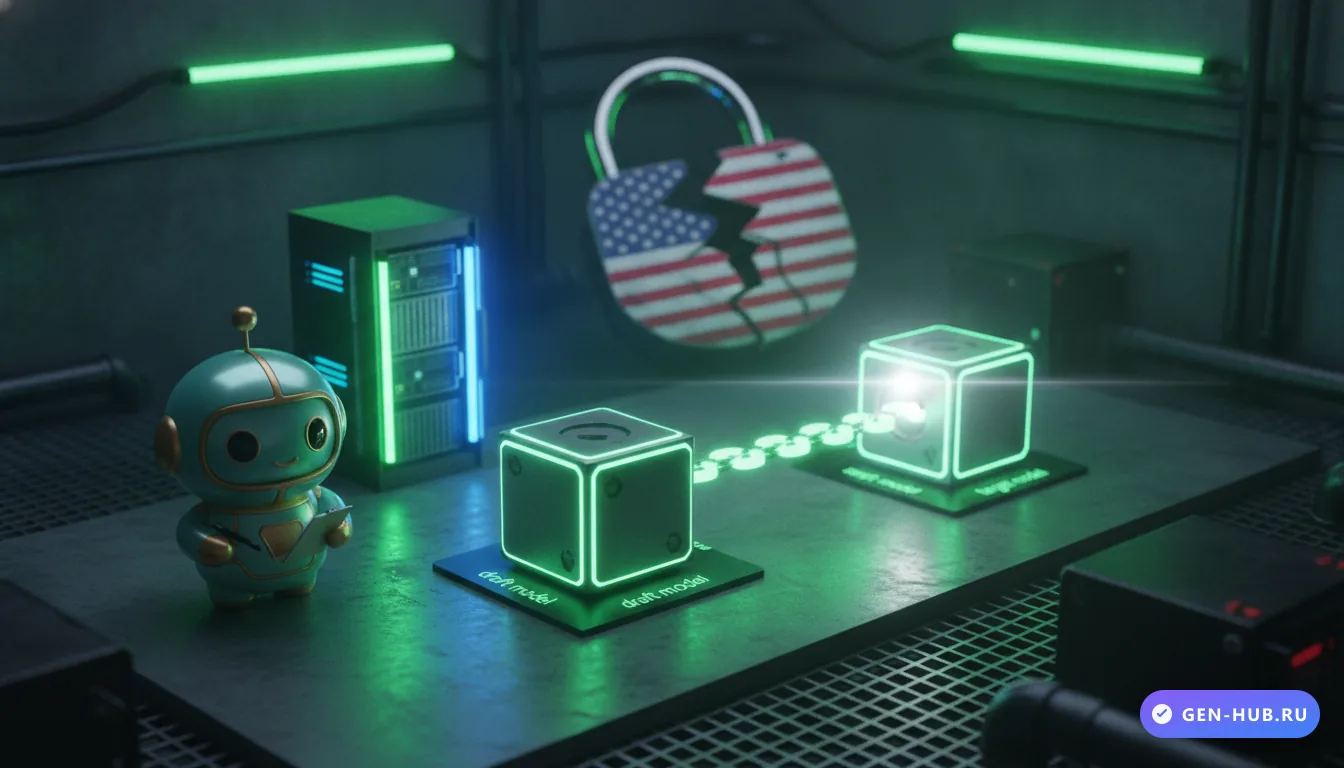
Есть ирония в том, что именно американские экспортные ограничения на чипы толкают китайских инженеров к изобретениям, которые делают эти ограничения менее эффективными. DeepSeek только что выпустил DSpark - и это не очередная маркетинговая "оптимизация", а принципиально новый подход к инференсу, который меняет расчеты для всей индустрии.
Ускорение на 60-85% на реальном трафике - не на синтетических бенчмарках в лаборатории, а в условиях живой нагрузки от пользователей. Это цифры, от которых у любого инфраструктурного директора начинают бегать глаза по строчке бюджета.
Как это работает: маленькая модель, большая хитрость
Классический инференс LLM - это конвейер одного токена за раз. Генерируем слово, ждем, генерируем следующее. При длинных ответах GPU простаивает, пользователь нервничает, счет за вычисления растет. Это фундаментальное узкое место, с которым индустрия живет годами.
DSpark решает его через спекулятивное декодирование с полуавторегрессивной генерацией. Схема такая: легкая вспомогательная модель-"черновик" быстро предлагает несколько токенов вперед, а большая целевая модель проверяет их пачкой. Если черновик угадал - система принимает сразу несколько токенов за один проход. Если нет - откатывается только на ошибочный участок.
Ключевое отличие DSpark от предшественников - комбинация параллельной и последовательной обработки в черновике. Чисто параллельные методы (вроде DFlash) быстро теряют точность на поздних позициях в цепочке кандидатов: токены дальше от начала все чаще отклоняются большой моделью. DSpark добавляет легкие последовательные блоки, которые учитывают зависимости между соседними токенами - и процент принятия остается высоким до конца цепочки.
Помимо этого, система не фиксирует длину пакета проверки заранее. Планировщик с оценкой уверенности в реальном времени смотрит на загрузку сервера и обрезает хвосты с низкой вероятностью принятия. При высоком трафике - меньше проверок, меньше потерь. При низком - больше спекуляций, выше скорость для каждого пользователя. Умно.
Цифры, которые стоит запомнить
По данным тестирования на реальном трафике DeepSeek-V4-Flash и DeepSeek-V4-Pro:
- Скорость генерации на пользователя: +60-85% - Общий системный throughput: до +661% - В сравнении с конкурирующими методами Eagle3 и DFlash - DSpark лидирует по всем категориям тестов
Фреймворк разработан совместно с Пекинским университетом, опубликован на GitHub и Hugging Face под лицензией MIT - то есть доступен всем, включая коммерческое использование без ограничений.
Протестировали не только на собственных моделях: DSpark показал прирост на Google Gemma и Alibaba Qwen. Это принципиально - значит, речь идет об универсальном инструменте, а не об узкоспециализированной оптимизации под конкретную архитектуру.
Стратегическое измерение: чипы как геополитический инструмент
Вот где история становится по-настоящему интересной. США последовательно затягивают экспортные ограничения на высокопроизводительные GPU - H100, H800, B200 в Китай не идут официально. Логика Вашингтона: без топового железа не будет топового ИИ.
DSpark эту логику подрывает. Один GPU, который раньше обслуживал 100 запросов, теперь обработает порядка 185. Меньше чипов на ту же нагрузку - или та же инфраструктура дает принципиально другую производительность. Для страны с ограниченным доступом к передовым полупроводникам это не просто технический апгрейд, а стратегический ресурс.
При этом я не стал бы игнорировать парадокс Джевонса: когда технология становится эффективнее, спрос на нее обычно растет пропорционально или быстрее. Освободившиеся вычислительные ресурсы DeepSeek почти наверняка направит на более длинные контексты, новые приложения и расширение пользовательской базы. Так что "снижение потребности в чипах" - тезис верный в краткосрочной перспективе, но в долгосрочной аппетиты только вырастут.
Тем не менее в моменте - это реальное ослабление рычага давления через контроль над железом.
Что это значит для разработчиков и бизнеса
Для разработчиков: DSpark - это готовый к использованию open-source инструмент с обученными контрольными точками, пайплайнами обучения и подробной технической документацией. MIT-лицензия снимает любые вопросы о коммерческом применении. Если вы деплоите Qwen или Gemma - есть смысл протестировать уже сейчас.
Для бизнеса: снижение стоимости инференса при той же железной базе напрямую влияет на unit-экономику AI-продуктов. На фоне историй о том, как Uber и Walmart вводят лимиты на токены сотрудникам из-за растущих расходов, подобные оптимизации - не академический интерес, а прямая экономия.
Для российской аудитории: модели DeepSeek-V4-Flash-DSpark и DeepSeek-V4-Pro-DSpark уже доступны на Hugging Face, скачать и запустить локально можно без VPN и без привязки карт. API DeepSeek также остается одним из немногих, доступных из России напрямую - хотя ситуация с платежными методами периодически меняется, стоит уточнять актуальный статус.
Итог
DSpark - это не маркетинговый ход и не очередная "оптимизация на 5%". Это методологически обоснованный прорыв в области инференса, подтвержденный независимым тестированием на нескольких архитектурах. DeepSeek снова демонстрирует, что ограничения в ресурсах иногда порождают более изящные решения, чем неограниченный доступ к железу.
Информация о выходе DSpark и его технических характеристиках подтверждена несколькими независимыми изданиями, освещавшими релиз на основе оригинальной документации и тестов компании.
Похожие новости

Apple ужесточает доступ к диску Mac из-за угроз со стороны ИИ-агентов
Apple объявила о новых ограничениях для функции "полного доступа к диску" в macOS - компания прямо указала, что ИИ-агенты существенно увеличат риски для конфиденциальности пользователей по мере своего развития.

OpenAI Dots: рабочий ИИ-агент, который заодно закажет ужин
OpenAI представила Dots - всегда активных агентов на базе GPT-6 Astra. Они работают как корпоративный софт, но при этом могут заказать бурито.
Ai2 открыла AstaBrief 8B: научные отчеты за 51 секунду
Allen Institute for AI выложил в открытый доступ модель AstaBrief 8B - она генерирует научные отчеты с цитатами в 3,5 раза быстрее Claude и стоит дешевле в обслуживании.